核心要点速览
- 携 2750 万美元 A 轮融资亮相:Phonic 发布专为调工具而生的语音大模型 Phonic-1(研发公司:Phonic(10 人语音 AI 团队,获 First Round 领投 2,750 万美元 A 轮);模型架构:Phonic-1 原生端到端语音对语音(Speech-to-Speech)大模型)。
- 告别“转文字→调模型→转语音”三段拼接:0.61 秒延迟如何消除电话客服的机械停顿(端到端延迟:约 610 毫秒(0.61 秒),支持自然打断与语气词反馈)。
- 语音智能体接外部数据库时,如何用精简 JSON 与流式语气词掩盖查库耗时(核心专长:边听用户说话边在后台异步触发外部 API 与数据库工具调用)。
携 2750 万美元 A 轮融资亮相:Phonic 发布专为调工具而生的语音大模型 Phonic-1
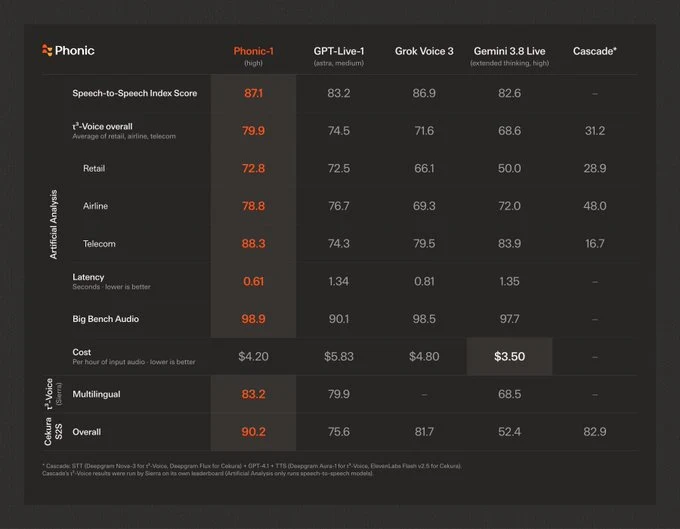
伴随 First Round 领投的 2,750 万美元 A 轮融资,10 人语音 AI 团队 Phonic 正式发布了《Phonic-1》端到端语音对语音大模型,专为实时智能体对话与工具调用场景打造。
出处[1]
告别“转文字→调模型→转语音”三段拼接:0.61 秒延迟如何消除电话客服的机械停顿
不同于传统的“语音转文字→文本大模型→文字转语音”三段式拼接,Phonic-1 直接在原生音频流上推理,端到端响应延迟约 0.61 秒,并能在听用户说话的同时后台异步触发 API 查询。
出处[1]
语音智能体接外部数据库时,如何用精简 JSON 与流式语气词掩盖查库耗时
接入语音智能体时,建议将外部工具的 JSON 参数结构精简到最小必填项,并开启流式自然语气词反馈,让查库等待完全无感。
出处[1]
X(推特)首发原帖
可在 X 上直接查看创作者发布的原帖与互动详情。
常见问题
Phonic-1在架构、参数或延迟上有哪些核心突破?
研发公司为Phonic(10 人语音 AI 团队,获 First Round 领投 2,750 万美元 A 轮),模型架构为Phonic-1 原生端到端语音对语音(Speech-to-Speech)大模型,端到端延迟为约 610 毫秒(0.61 秒),支持自然打断与语气词反馈。不同于传统的“语音转文字→文本大模型→文字转语音”三段式拼接,Phonic-1 直接在原生音频流上推理,端到端响应延迟约 0.61 秒,并能在听用户说话的同时后台异步触发 API 查询。
出处[1]
开发者和创作者目前可以通过哪些渠道接入实测?
核心专长为边听用户说话边在后台异步触发外部 API 与数据库工具调用。接入语音智能体时,建议将外部工具的 JSON 参数结构精简到最小必填项,并开启流式自然语气词反馈,让查库等待完全无感。
出处[1]
参考链接与官方出处
- X (@moinnadeem)x.com