核心要点速览
- 官方模型卡(NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16)明确标注支持语言为英语,未对日语或中文日常对话质量做官方保证。
- 采用循环复用同一权重块(Loop)的架构设计,通过调整循环次数在推理耗时与回答质量之间做取舍,而非单纯扩大模型体积。
- 官方同时放出了 BF16 版与 NVFP4 量化版模型卡,并给出了基于 vLLM 与 llama.cpp 的运行说明,部署前需按具体格式核对软硬件兼容性。
官方模型卡标注支持英语,非英语环境使用前需先明确用途
由 NVIDIA 研究员 Oleksii Kuchaiev(@kuchaev)于 2026 年 10 月 17 日在 X 分享后,4B 规模的《NVIDIA Dory1.0》引起了不少本地大模型玩家的兴趣。不过在动手下载前,首先要看清官方模型卡(https://huggingface.co/nvidia/NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16)上的语言说明:官方明确列出的支持语言仅为英语(English)。
虽然在实际调用时向它输入日语或中文提示词也能得到回复,但这并不代表官方验证或保证了非英语语种的推理准确度。如果是为了研究小参数循环推理机制或处理英文开发任务,它非常值得尝试;但若想直接当作主力母语日常写作助手,则需先自行比对输出是否存在事实偏差。
出处[1]
靠增加循环次数换取推理深度:计算时间与质量的权衡
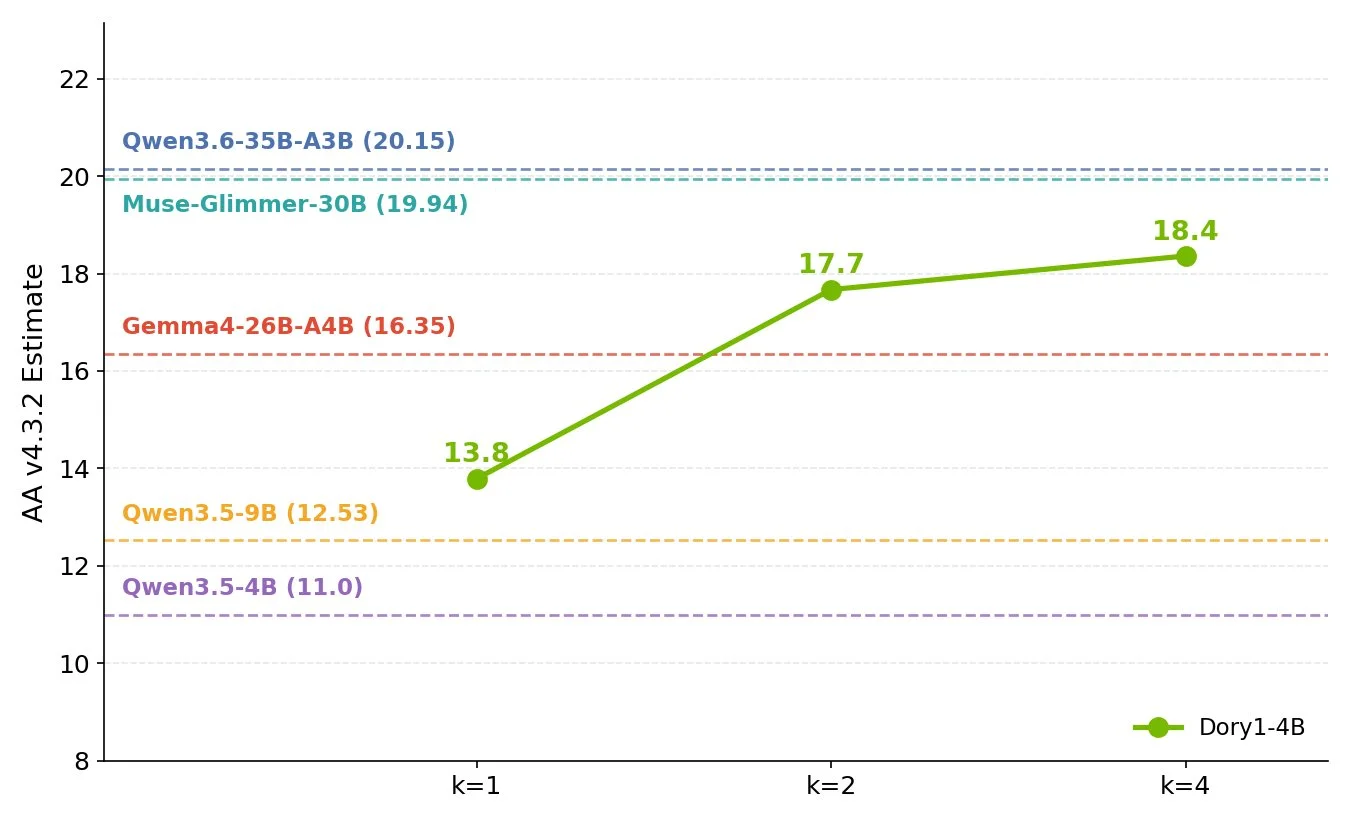
Dory1.0 与常规 4B 稠密模型的最大区别,在于它采用了「对同一权重块进行多次循环迭代(Loop)」的架构。官方资料展示了不同循环次数下的表现对比,其核心思路是不增加静态参数体积,而是让数据在模型内部多跑几圈来深化推理。
当然,调高循环次数并不是白拿的免费性能提升,它会直接转化为更长的推理等待时间与更高的算力消耗。在本地测试时,建议用同一道测试题固定上下文设置,同时记录不同循环次数下的回答准确度与生成耗时,从而找到适合自己显卡的平衡点。
出处[1]
区分 BF16 与 NVFP4 量化权重,匹配 vLLM 或 llama.cpp 环境
在 Hugging Face 上,NVIDIA 官方除了提供原版精度的 BF16 仓库外,还单独发布了 NVFP4 量化版模型卡(https://huggingface.co/nvidia/NVIDIA-Nemotron-Labs-Dory1.0-4B-NVFP4),并在文档中列出了通过 vLLM 与 llama.cpp 启动推理的官方路径。
需要注意,看到「4B」和「量化版」并不意味着任何旧显卡或任意前端软件拖进去就能跑——特别是 NVFP4 这种特定浮点量化格式,对 GPU 架构与推理后端版本都有明确要求。部署前请务必先阅读对应模型卡里的依赖说明与开源许可证。
X(推特)首发原帖
可在 X 上直接查看创作者发布的原帖与互动详情。
常见问题
NVIDIA Dory1.0-4B 官方支持日语或中文吗?
官方模型卡明确列出的支持语言只有英语(English)。虽然模型可能对其他语言的输入做出回应,但官方并未保证非英语环境的输出质量。
出处[1]
既然只有 4B 参数,普通轻薄笔记本电脑能直接流畅跑吗?
不能只看 4B 这个数字下结论。实际能否运行取决于你选择的是 BF16 原版还是 NVFP4 量化版、所使用的推理框架(vLLM 或 llama.cpp)、上下文长度以及显卡架构,请先核对官方模型卡列出的执行环境要求。
出处[1]
参考链接与官方出处
- NVIDIA Dory1.0-4B BF16公式モデルカードhuggingface.co
- NVIDIA Dory1.0-4B NVFP4公式モデルカードhuggingface.co
- Oleksii Kuchaievのモデル紹介x.com